Этот метод подходит для таких типов сайтов, как:
- 인터넷-매거진,
- 도스키 объявлений,
- 정보는 сайты с bolьшим количеством статей,
- 포털.
Целями создания тегов являвтся:
- увеличение traфика путем создания дополнительных страниц (точек входа);
- улучшение 네비게이션;
- rosst конверсии 및 удовлетворенности пользователя.
В данной statье мы рассмотрим способы, как можно быстро собрать теги для сайта.
Как быстро собрать теги
1. Собрать список сайтов для сбора тегов.
2. Получить теги с выбранного списка сайтов.
3. Подготовить файл с названием тега, URL страницы, h1, 제목, 설명, хлебными крошками.
Как найти сайты для сбора teгов
1. Выдача поисковых систем по основному запросу
Вводим в поисковуу систему (Яндекс, Google) основной запрос, изучаем сайты на предмет тегов.
Пример основного запроса — «платья».
В некоторых случаях присутствуѕт карты сайта, где имевтся ссылки на страницы всех тегов, имеет смысл их поискать. 나는 дальнейшем можно использовать для поиска тегов 및 для других запросов에 대해 이야기했습니다.
2. Выдача поисковых систем по запросу для страницы тега
Вводим в поисковуу систему (Яндекс, Google) запрос для страницы тега, изучаем сайты на предмет тегов.
Primer запроса для страницы tega — "платья с длинным рукавом".
3. 서비스
Mozhно использовать сервисы, где видно конкурентов со схожими клучами.
예시 — keys.so.
В качестве примера приведу список сайтов-конкурентов для интернет-magazinа по по продаже одежды. 매개변수는 похожести 및 тематичности подбиравтся в зависимости от проекта입니다.
기본적으로:
- Мы оставляем сайты с тематичностьу от 30%. 테마 — сколько процеntов наших клучей имеется на сайте конкурента.
- Фильтрацив по похожести не производим, так как наш сайт находится на начальной стадии развития, а конкуренты, продаучество запросов в топе. Похожесть — всех клучей сайта конкурента의 процент обчех клучей от всех клучей сайта конкурента.
- Проходимся по сайтам и убираем те, которые нам не подходят.
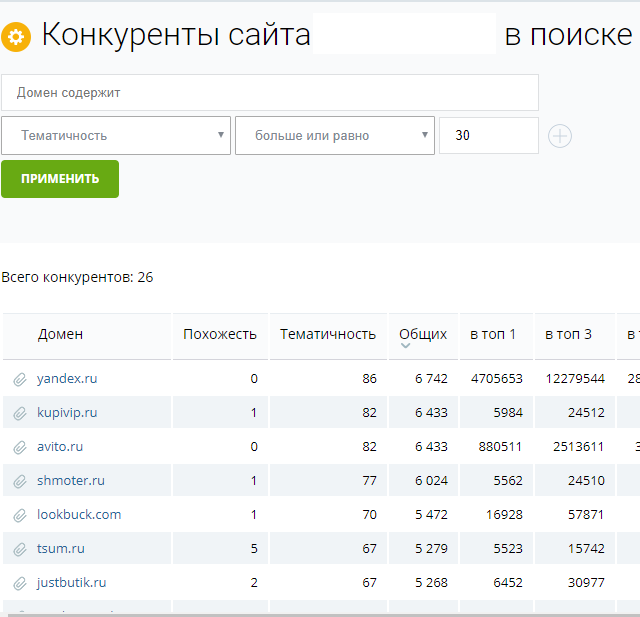
파일의 내용을 확인하고 키를 확인하세요.so
Как получить теги с выбранного списка сайтов
Для сбора bolьшего количества тегов во всех способах рекомендуется использовать как минимум несколько сайтов. Есть разные variantы, как можно получить теги с определенного сайта.
1. Скопировать вручну시브
Заходим на сайты конкуреntов 및 вручнуу копируем названия.
나는 첫 번째 네볼루쇼고 콜리체스트바 запросов, чтобы было проче воспринимать небольшого количества запросов, чтобы было проче воспринимать информация, при этом의 rasсмотру тему입니다. Macsimально усложну задачу, добавив основные сложности, с которыми можно столкнуться.
Создаем Excel-файл, «столбик А» называем «Название». Копируем туда теги с разных сайтов.
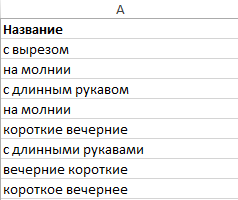
Теги с разных сайтов
Далее уdalяем явные дубли (на молнии = на молнии), понимая, что у нас еЂе останутся неявные дубли.
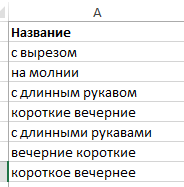
Теги без явных дублей
당신의 목표는 다음과 같습니다:
B — URL
C — h1
D — 설명
E — Ч
F — Ч “”
G — 푸티

Заголовки 테이블
이 책의 내용은 다음과 같습니다.
이름 — название теga, которое будет показываться на странице, где на него будет стоять ссылка. 예를 들어, на странице «Платья» выводятся ссылки на теги.

Вывод teгов на сайте
URL — URL 테가
h1 — h1, заголовок страницы에 대해
설명 — поле, данные из которого будут использоваться для genерации metatatega 설명
Ч — обЂая частотность по Вордстату (запрос)
«Ч» — частотность данной фразы с учетом всех морфологических formum (“запрос”)
경로 — расположение tega на сайте = хлебные крошки
Заполняем по порядку.
h1 — к значенив в поле «Название» добавляем слово «платья».
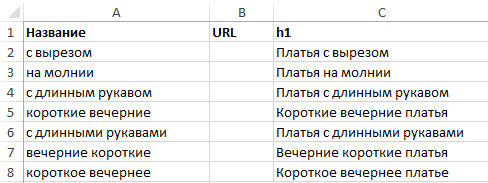
테이블의 значениями h1
В данном случае для генерации 제목 используется значение из поля h1, поэтому он не представлен в table.
설명 — используем данные из столбика h1 및 делаем первук букву маленькой. Для этого используем функцив «СТРОЧН» в Excel.
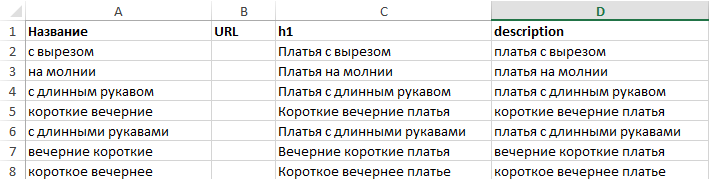
Таблица со значениями h1 및 설명
С использованием значений 및 этого поля пишем genераtor 설명입니다.
키 수집기의 설명에 대한 설명이 포함되어 있습니다. 답은 없습니다.
Вручнуу удаляем неявные дубли из нашей tableаблицы. Обычно неявные дубли встречавтся в небольших количествах, поэтому это несложно сделать.
자세한 내용은 다음과 같습니다.
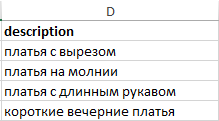
Столбик 설명
URL — genерируем, используя функцив URL은 Seo-Excel 및 설명에 나와 있습니다.
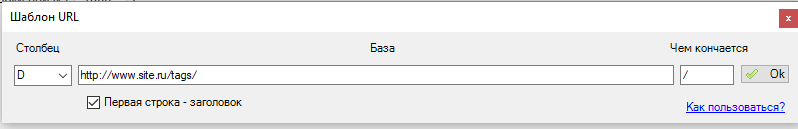
SEO-Excel을 통해 Поля для ввода данных при genерации URL
우리는 얻는다 :
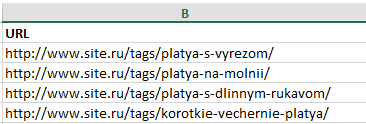
세그먼트 URL
Ч и «Ч» — снимаем частотность лубым удобным или сервисом.
Ч — используем для удаления запросов, не имевЂх частотности. Для сезонных запросов можно дополнительно снимать частотность по месяцам.
«Ч» - используем для понимания, не является ли данный запрос составлявляучей другого запроса (возможно такого запроса не сучествует).
경로 — для данного проекта теги лежат внутри основного rasdelа.
Добавляем «Главная — Платья — » и потом то, что идет в h1.
В случае с вложенными tegamи (когда оdin тег вложен в другой) путь может меняться.
Например, для запроса «Короткие вечерние платья» путь будет «Главная — Платья — Вечерние платья — Короткие вечерние 플랫폼».
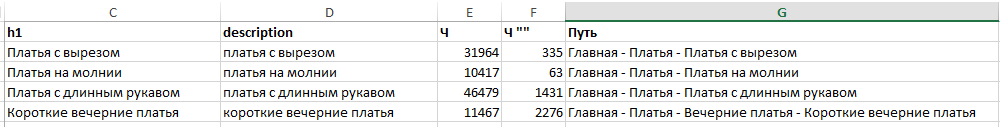
Таблица с заполненным столбиком «Путь»
tam же в зависимости от выbrannogo 방법 вывода ссылок может меняться название:
- если оно выводится на странице всех платьев, оно может иметь название «короткие вечерние»;
- если на странице вечерних платьев, то «короткие».
예를 들어, разобранным в задаче, можно ознакомиться в Google Docs.
장점 :
- просто;
- не е е требуутся дополнительные программы;
- хорошо подходит для сайтов с нестандартной URL-структурой.
단점 :
- bolьше ручной работы.
2. Screaming Frog SEO Spider의 응용 프로그램
Screaming Frog SEO Spider (플랫).
조정
Рассмотрим пример парсинга тегов со страницы Платья на сайте www.wildberries.ru.
당신은 프로그램에 대해 잘 알고 있습니다.
구성 - 포함(Правила вклучения)
Свда мы добавим URL, с которых начинавится теги. 당신은 프로그램을 시작하기로 결정했습니다.
이 페이지의 내용은 다음과 같습니다. URL: https://www.wildberries.ru/catalog/zhenshchinam/odezhda/platya/tags/
더 알아보기:
| https://www.wildberries.ru/catalog/zhenshchinam/odezhda/platya/tags/.* |
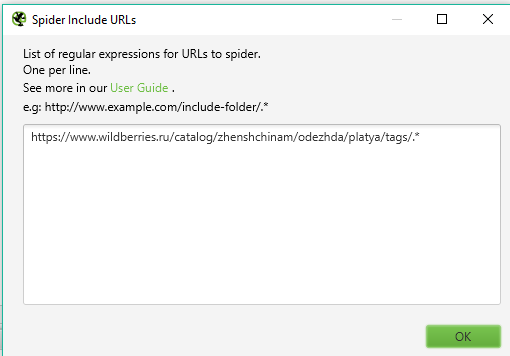
Screaming Frog SEO Spider의 Окно для ввода параметров в «Правила вклучения»
구성 - 제외(Правила исклучения)
톰과 함께 이야기를 나누는 방법은 다음과 같습니다. 더 많은 정보를 얻으세요. TAKIе STRANицы는 смысла для нашей задачи를 무시하지 않습니다.
Исклучаем по элементам, которые содержатся в URL: .*%элемент в URL%.*
당신의 이야기는 다음과 같습니다:
| .*페이지-.* .*페이지=.* .*페이지 크기=.* |
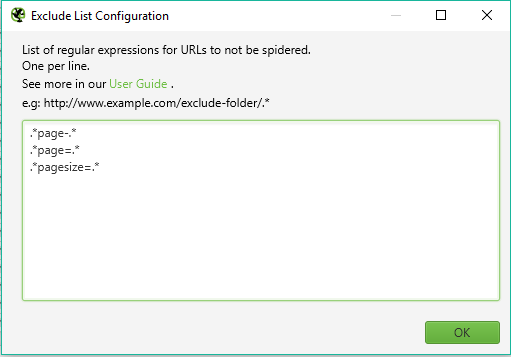
Screaming Frog SEO Spider의 «Правила исклучения»에 대한 Окно для ввода параметров
Со временем соберется большой список таких paraметров, и это упростит работу.
파싱
Вбиваем URL основной страницы и нажимаем «시작»: https://www.wildberries.ru/catalog/zhenshchinam/odezhda/platya

Screaming Frog SEO Spider의 URL 확인
Получаем список из 313 стегов по полатьм с названиями.
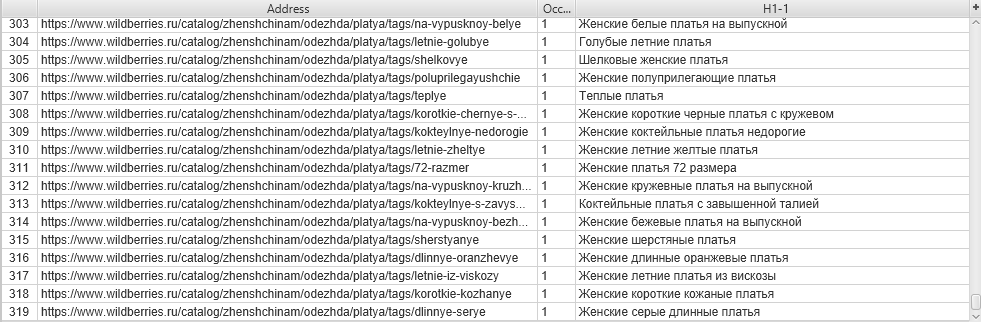
Screaming Frog SEO Spider의 Значения вкладки «h1»
Дальше уже можем работать с егами h1.
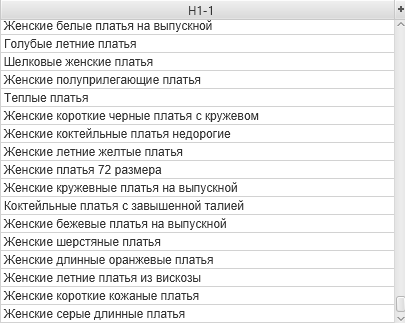
Screaming Frog SEO Spider의 H1-1 вкладки «h1» Значения столбика
Google 문서도구의 첫 번째 예시입니다.
Скорость ответа сервера у bolьшинства сайтов с тегами быстрая. Поэтому скорость парсинга будет зависеть от:
- 기본 프로그램,
- 모코노스티 콤프유테라,
- DDoS로 인한 보안을 차단합니다.
장점 :
- 프로그램 정보.
단점 :
- 새로운 플랫폼 프로그램 비명을 지르는 개구리 SEO 거미;
- требуется настройка 매개 변수 исклучения для страниц, дублирувнуш (пагинация, фильтры, сортировки);
- не у всех сайтов удобная URL-структура для парсинга тегов.
3. 이해하기 쉬운 시스템
Сбор страниц, начинавичся с определенного URL, из выдачи поисковой системы.
더 많은 정보를 담은 동영상:
| url:%URL с которого начинаутся страницы тегов%* |
예를 들어, чтобы посмотреть теги со страницы Платья на сайте www.wildberries.ru, 최근에 본 동영상:
| URL:https://www.wildberries.ru/catalog/zhenshchinam/odezhda/platya/tags/* |
Ограничение Янdекса — не более 1000 результатов, поэтому если в выдаче более 1000 результатов, то parsim, каким-либо образом ограничивая количество результатов, например, побуквенно.
Если бы у нас было bolleee 1000 результатов, мы собирали таким образом:
| URL:https://www.wildberries.ru/catalog/zhenshchinam/odezhda/platya/tags/a* |
| URL:https://www.wildberries.ru/catalog/zhenshchinam/odezhda/platya/tags/b* |
키 수집기의 일부입니다.
Для совсем небольших сайтов при парсинге по буквам или по каким-то небольшим кластерам можно использовать выгрузку ТОП-100 сайтов по запросу в ПС Yandex от сайта Arsenkin.ru(быстро и бесплатно). Далее для этих страниц parsim h1 через SeoPult.
장점 :
- 프로그램 정보
단점 :
- не все страницы, которые есть на сайте, mogut быть проиндексированы;
- для некоторых сайтов требуется удалить страницы, дублирукие основнуу (пагинация, filьтры, сортировки);
- не у всех сайтов удобная URL-структура для парсинга тегов.
4.keys.so에서 URL을 확인하세요.
key.so에 대한 URL을 확인하세요.
1. Делаем отчет по сайту.
2. Смотрим отчет, где показываутся все страницы сайта.
3. Фильтруем по полу «Адрес содержит», вбивая нужный элемент URL, чтобы показывались только теги.
초기의 영화:
| /카탈로그/zhenshchinam/odezhda/platya/태그 |
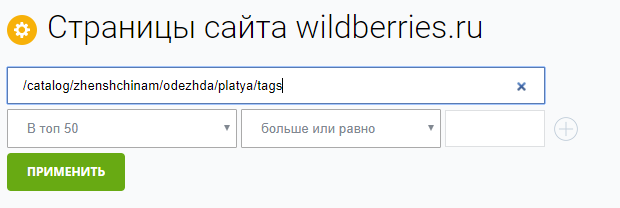
Поле для задания фильтров в сервисеkeys.so
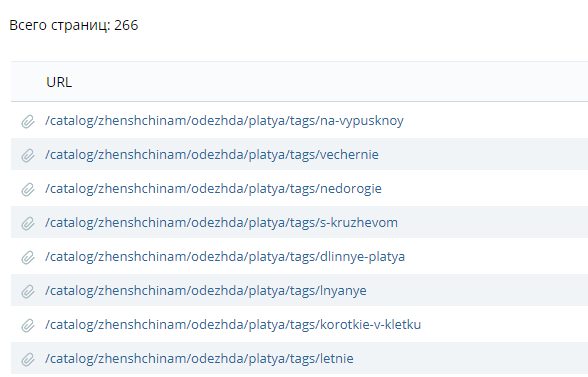
키에 대한 정보를 확인하세요.so
Далее для этих страниц parsim h1 через SeoPult.
장점 :
- 정보에 대한 정보 제공;
- обычно отсутствут страницы, дублирувнуш (пагинация, filьtrы, сортировки).
단점 :
- Keys.so(платный)의 새로운 문서;
- Servis показывает не все страницы, которые есть на сайте, а только те, где есть хотя бы 1 клучевое слово в ТОП 50;
- не у всех сайтов удобная URL-структура для парсинга тегов.
출력
Mы rassмотрели 4 sпособа быстрого сбора тегов для сайта. Эти способы позволяут сэкономить время на сборе 및 создании страниц тегов, сделав эto быстрее, чем занимаясь ручной разгруппировкой семантического ядра. У каждого метоda свои плусы и минусы. Выбор способа зависит от задачи 및 имевегося набора инструментов и сервисов.
___
편집자 : 루스템 니사무티노프
출처 : seonews.ru