Этот метод подходит для таких типов сайтов, как:
- интернет-магазины、
- доски объявлений、
- информационные сайты с бользим количеством статей,
- そうです。
Целями создания тегов являются:
- увеличение трафика путем создания дополнительных страниц (точек входа);
- улучление навигации;
- Сост конверсии и удовлетворенности пользователя。
В данной статье мы рассмотрим способы, как можно быстро собрать теги для сайта.
Как быстро собрать теги
1. Собрать список сайтов для сбора тегов.
2. Получить теги с выбранного списка сайтов.
3. Подготовить файл с названием тега、URL страницы、h1、タイトル、説明、хлебными крозками。
Как найти сайты для сбора тегов
1. Выдача поисковых систем по основному запросу
Вводим в поисковую систему (Яндекс, Google) основной запрос, изучаем сайты на предмет тегов.
Пример основного запроса — «платья».
В некоторых случаях присутствуют карты сайта, где имеются ссылки на страницы всех тегов, имеет смысл ихそうです。 Эти же сайты в дальнейбем можно использовать для поиска тегов и для других запросов.
2. Выдача поисковых систем по запросу для страницы тега
Вводим в поисковую систему (Яндекс, Google) запрос для страницы тега, изучаем сайты на предмет тегов.
Пример запроса для страницы тега — «платья с длинным рукавом».
3. セルヴィス
Можно использовать сервисы, где видно конкурентов со схожими ключами.
例 — keys.so.
В качестве примера приведу список сайтов-конкурентов для интернет-магазина по продаже одежды. Параметры похожести и тематичности подбираются в зависимости от проекта.
V ダンノム プライマー:
- Мы оставляем сайты с тематичностью от 30 %。 Тематичность — сколько процентов назих ключей имеется на сайте конкурента.
- Фильтрацию по похожести не производим, так как нал сайт находится на начальной стадии развития, а конкуренты,あなたの質問に答えてください。 Похожесть — процент общих ключей от всех ключей сайта конкурента.
- Проходимся по сайтам и убираем те, которые нам не подходят.
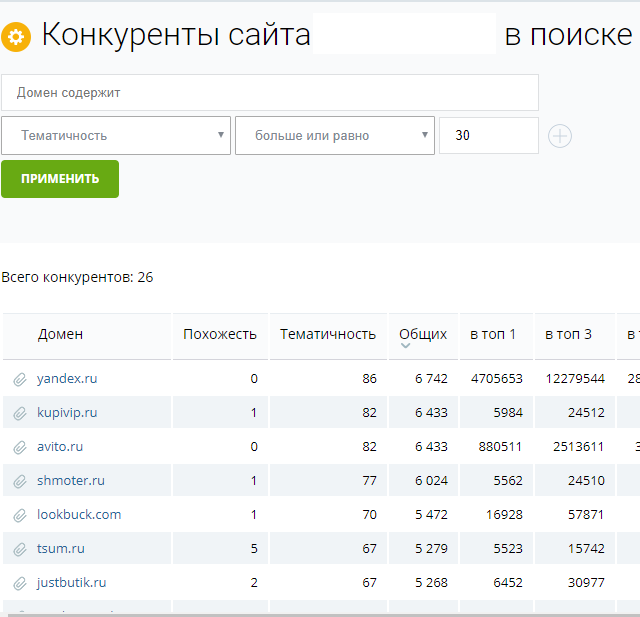
Выгрузка по фильтрам из сервиса Keys.so
Как получить теги с выбранного списка сайтов
Соличества тегов во всех рекомендуется использовать как минимум несколько сайтов. Есть разные варианты, как можно получить теги с определенного сайта.
1. Скопировать вручную
Заходим на сайты конкурентов и вручную копируем названия.
Я рассмотрю тему на примере небольго количества запросов, чтобы было проще воспринимать информацию, при этом максимально усложню задачу, добавив основные сложности, с которыми можно столкнуться.
Excel-файл、«столбик А» называем «Название»。 Копируем туда теги с разных сайтов.
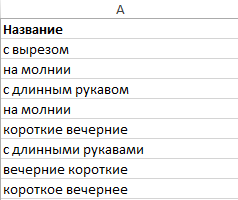
Теги с разных сайтов
Далее удаляем явные дубли (на молнии = на молнии), понимая, что у нас еще останутся неявные дубли.
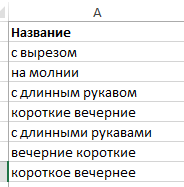
Теги без явных дублей
Заполняем названия остальных столбиков:
B — URL
C — h1
D — 説明
E — Ч
F — Ч “”
G — ピュー

Заголовки таблицы
В итоге получаем поля:
名前 — название тега, которое будет показываться на странице, где на него будет стоять ссылка. Например、на странице «Платья» выводятся ссылки на теги。

Вывод тегов на сайте
URL — URL テガ
h1 — h1, он же заголовок страницы
説明 — поле, данные из которого будут использоваться для генерации метатега description
Ч — общая частотность по Вордстату (запрос)
「Ч」 — частотность данной фразы с учетом всех морфологических форм («запрос»)
パス — расположение тега на сайте = хлебные крозки
Заполняем по порядку。
h1 — к значению в поле «Название» добавляем слово «платья».
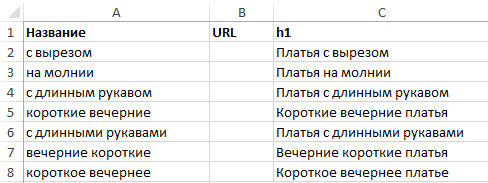
Таблица со значениями h1
В данном случае для генерации title используется значение из поля h1, поэтому он не представлен в таблице.
説明 — используем данные из столбика h1 и делаем первую букву маленькой. Excel で「СТРОЧН」を実行します。
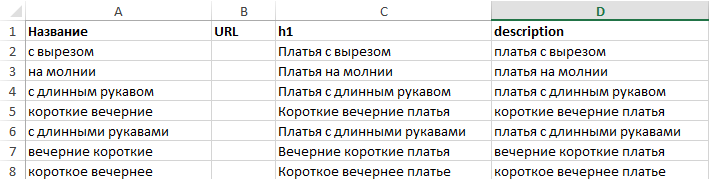
Таблица со значениями h1 и description
説明をご覧ください。
Key Collector の説明を参照してください。 Отмечаем неявные дубли.
Вручную удаляем неявные дубли из назей таблицы. Обычно неявные дубли встречаются в небользих количествах, поэтому это несложно сделать.
В итоге остается:
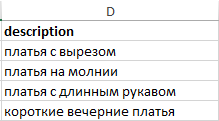
ストルビクの説明
URL — генерируем, используя функцию URL от Seo-Excel の説明。
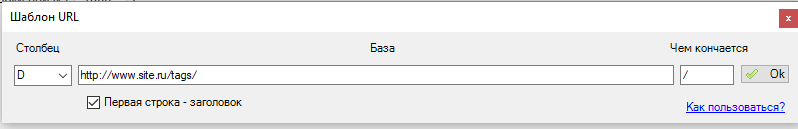
SEO-Excel の URL を確認する
我々は得ます:
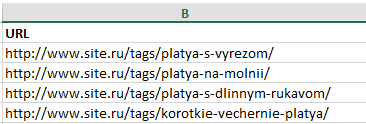
Сгенерированные URL
Ч и 「Ч」 — снимаем частотность любым удобным инструментом или сервисом.
Ч — используем для удаления запросов, не имеющих частотности. Ожно дополнительно снимать частотность по месяцам.
「Ч」 - используем для понимания, не является ли данный запрос составляющей другого запроса (возможно такого запроса не)そうです)。
パス — для данного проекта теги лежат внутри основного раздела.
Добавляем «Главная — Платья — » и потом то, что идет в h1.
В случае с вложенными тегами (когда один тег вложен в другой) путь может меняться.
Например, для запроса «Короткие вечерние платья» пудет «Главная — Платья — Вечерние платья — Короткие Сечерние платья»。
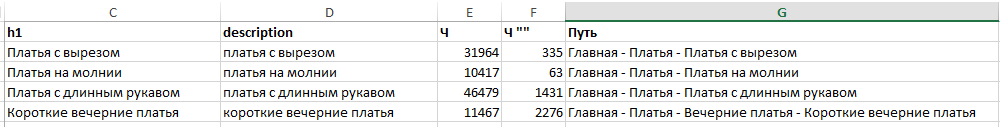
Таблица с заполненным столбиком «Путь»
Там же в зависимости от выбранного метода вывода ссылок может меняться название:
- если оно выводится на странице всех платьев, оно может иметь название «короткие вечерние»;
- если на странице вечерних платьев, то «короткие»。
Google ドキュメントを利用して、オンラインで簡単にアクセスできます。
長所:
- просто;
- не требуются дополнительные программы;
- URL-структурой をご覧ください。
短所:
- Сольсе ручной работы。
2. Парсинг программой Screaming Frog SEO Spider
叫ぶカエル SEO スパイダー (платная)。
調整
www.wildberries.ru をご覧ください。
あなたのことを忘れないでください。
構成 — インクルード (Правила включения)
URL を参照してください。 Эти теги будет добавлять программа.
Все теги на странице платьев начинаются с такого URL: https://www.wildberries.ru/catalog/zhenshchinam/odezhda/platya/tags/
Саким образом:
| https://www.wildberries.ru/catalog/zhenshchinam/odezhda/platya/tags/.* |
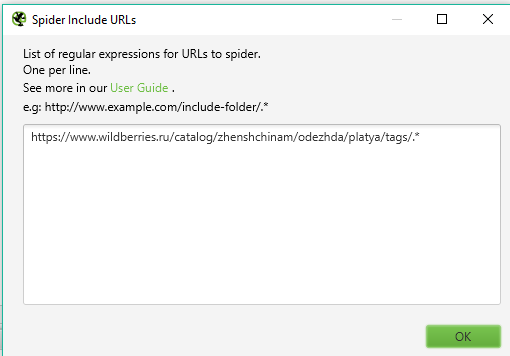
Окно для ввода параметров «Правила включения» « Screaming Frog SEO Spider
構成 — 除外 (Правила исключения)
Наза задача состоит в том, чтобы исключить страницы пагинации, сортировки и страницы такого типа, которые по смыслу дублируют основную страницу。 Такие страницы не несут смысла для назей задачи.
URL: .*%элементам、которые содержатся 、URL%.* を参照してください。
私が得たものはこれです:
| 。*ページ-。* .*ページ=.* .*ページサイズ=.* |
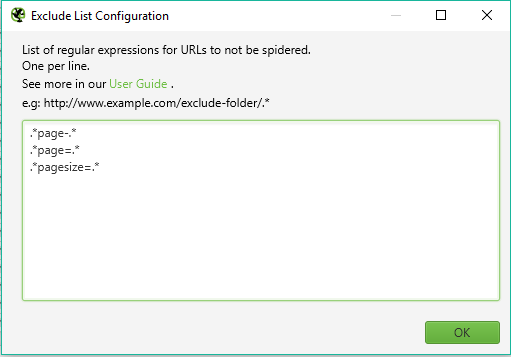
Окно для ввода параметров «Правила исключения» « Screaming Frog SEO Spider
Со временем соберется бользой список таких параметров, и это упростит работу.
解析中
Вбиваем URL основной страницы и нажимаем «スタート»: https://www.wildberries.ru/catalog/zhenshchinam/odezhda/platya

URL と Screaming Frog SEO Spider のリンク
Получаем список из 313 страниц тегов по Платьям с названиями.
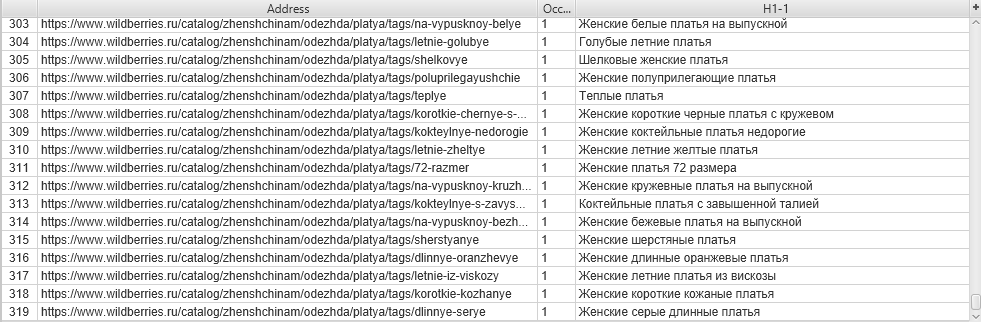
Значения «h1» « Screaming Frog SEO Spider
же можем работать с тегами h1.
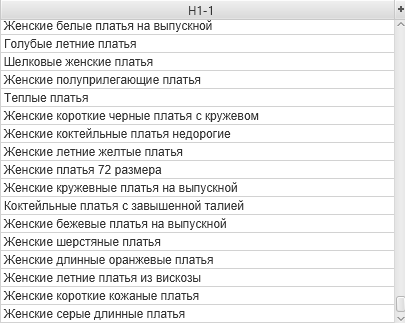
Значения столбика H1-1 «h1» « Screaming Frog SEO Spider
Google ドキュメントを利用して、オンラインで簡単にアクセスできます。
Скорость ответа сервера у бользинства сайтов с тегами быстрая. Поэтому скорость парсинга будет зависеть от:
- 必要に応じて、
- мощности компьютера,
- DDoS の脅威となります。
長所:
- ありがとうございます。
短所:
- нужна платная программа Screaming Frog SEO Spider;
- требуется настройка параметров исключения для страниц, дублирующих основную (пагинация, фильтры, сортировки);
- не у всех сайтов удобная URL-структура для парсинга тегов.
3. Парсинг из поисковой системы
Сбор страниц, начинающихся с определенного URL, из выдачи поисковой системы.
結果は次のとおりです:
| url:%URL с которого начинаются страницы тегов%* |
Например、чтобы посмотреть теги со страницы Платья на сайте www.wildberries.ru, 必要な情報:
| URL:https://www.wildberries.ru/catalog/zhenshchinam/odezhda/platya/tags/* |
Ограничение Яндекса — не более 1000 результатов, поэтому если в выдаче более 1000 результатов, то парсим, каким-либо образом ограничивая количество результатов、например、побуквенно。
1000 ドルを超えると、次のようになります:
| URL:https://www.wildberries.ru/catalog/zhenshchinam/odezhda/platya/tags/a* |
| URL:https://www.wildberries.ru/catalog/zhenshchinam/odezhda/platya/tags/b* |
キーコレクターの役割を果たします。
Можно использовать выгрузку для совсем небольгех сайтов при парсинге по буквам или по каким-то небольсим кластерам можно использовать выгрузку ТОП-100 сайтов по запросу в ПС Yandex от сайта Arsenkin.ru (быстро и бесплатно). SeoPult にアクセスしてください。
長所:
- 必要な情報を入力してください。
短所:
- не все страницы, которые есть на сайте, могут быть проиндексированы;
- для некоторых сайтов требуется удалить страницы, дублирующие основную (пагинация, фильтры, сортировки);
- не у всех сайтов удобная URL-структура для парсинга тегов.
4. URL とkeys.soを入力します。
URL とkeys.soを参照してください。
1. ロシア語。
2. Смотрим отчет, где показываются все страницы сайта.
3. Фильтруем по полю «Адрес содержит», вбивая нужный элемент URL, чтобы показывались только теги.
概要:
| /catalog/zhenshchinam/odezhda/platya/tags |
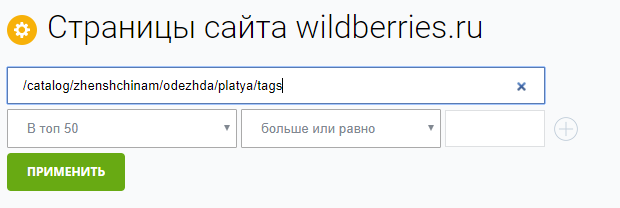
Keys.so を使用してください。
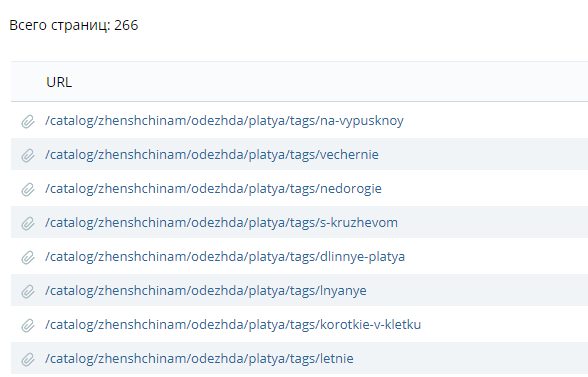
Список отфильтрованных страниц в сервисе Keys.so
SeoPult にアクセスしてください。
長所:
- сбор информации через сервис;
- обычно отсутствуют страницы、дублирующие основную (пагинация、фильтры、сортировки)。
短所:
- нужен доступ в Keys.so (платный);
- сервис показывает не все страницы, которые есть на сайте, а только те, где есть хотя бы 1 ключевое слово в ТОП 50;
- не у всех сайтов удобная URL-структура для парсинга тегов.
出力
Мы рассмотрели 4 способа быстрого сбора тегов для сайта. Эти способы позволяют сэкономить время на сборе и создании страниц тегов, сделав это быстрее, чем занимаясь ручной разгруппировкой семантического ядра。 У каждого метода свои плюсы и минусы. Выбор способа зависит от задачи имеющегося набора инструментов и сервисов.
___
編集者: Рустем Низамутинов
出所: seonews.ru