Этот метод подходит для таких типов сайтов, как:
- интернет-магазины,
- доски объявлений,
- информационные сайты с большим количеством статей,
- 门户。
Целями создания тегов являются:
- увеличение трафика путем создания дополнительных страниц (точек входа);
- улучшение навигации;
- рост конверсии 和 удовлетворенности пользователя。
В данной статье мы рассмотрим способы, как можно быстро собрать теги для сайта.
Как быстро собрать теги
1. Собрать список сайтов для сбора тегов。
2. Получить теги с выбранного списка сайтов。
3. Подготовить файл с названием тега, URL страницы, h1, 标题, 描述, хлебными крошками.
Как найти сайты для сбора тегов
1. Выдача поисковых систем по основному запросу
Вводим в поисковую систему (Яндекс, Google) основной запрос, изучаем сайты на предмет тегов。
示例 основного запроса — «платья»。
Внекоторых случаях присутствуют карты сайта,где имеются ссылки на страницы всех тегов,имет смысл их поискать。 Эти же сайты в дальнейшем можно использовать для поиска тегов и для других запросов.
2. Выдача поисковых систем по запросу для страницы тега
Вводим в поисковую систему (Яндекс, Google) запрос для страницы тега, изучаем сайты на предмет тегов.
示例 запроса для страницы тега — «платья с длинным рукавом»。
3. 服务
Можно использовать сервисы, где видно конкурентов со схожими ключами.
示例 — keys.so.
В качестве примера приведу список сайтов-конкурентов для интернет-магазина по продаже одежды。 Параметры похожести и тематичности подбираются в зависимости от проекта.
示例:
- Мы оставляем сайты с тематичностью от 30 %。主题 — сколько процентов наших ключей имеется на сайте конкурента。
- Фильтрацию по похожести не производим, так как наш сайт находится на начальной стадии развития, а конкуренты, продающие одежду, имеют очень большое количество запросов в топе. Похожесть — процент общих ключей от всех ключей сайта конкурента。
- Проходимся по сайтам и убираем те, которые нам не подходят。
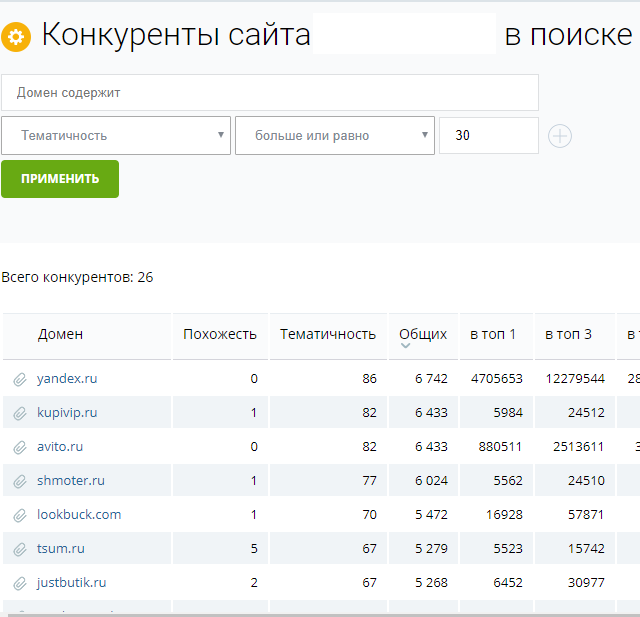
Выгрузка по фильтрам из сервиса keys.so
Как получить теги с выбранного списка сайтов
Для сбора большего количества тегов во всех способах рекомендуется использовать как минимум несколько сайтов。 Есть разные варианты, как можно получить теги с определенного сайта.
1. Скопировать вручную
Заходим на сайты конкурентов 和 вручную копируем названия。
Я рассмотрю тему на примере небольшого количества запросов, чтобы было проще воспринимать информацию, при этом максимально усложню задачу, добавив основные сложности, с которыми можно столкнуться.
Создаем Excel-файл,«столбик А» называем «Название»。 Копируем туда теги с разных сайтов。
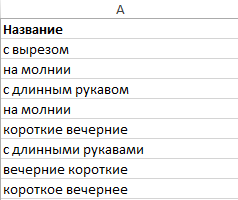
Теги с разных сайтов
Далее удаляем явные дубли (на молнии = на молнии), понимая, что у нас еще останутся неявные дубли.
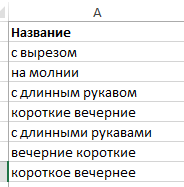
Теги без явных дублей
Заполняем названия остальных столбиков:
B — URL
C — h1
D — 描述
E — Ч
F — Ч “”
G — Путь

Заголовки таблицы
重要信息:
名称 — название тега,которое будет показываться на странице,где на него будет стоять ссылка。 Например, на странице «Платья» выводятся ссылки на теги.

Вывод тегов на сайте
网址 — URL 标签
h1 — h1, он же заголовок страницы
描述 — поле, данные из которого будут использоваться для генерации метатега 描述
Ч — общая частотность по Вордстату (запрос)
«Ч» — частотность данной фразы с учетом всех морфологических форм («запрос»)
路径 — расположение тега на сайте = хлебные крошки
Заполняем по порядку。
h1 — к значению в поле «Название» добавляем слово «платья»。
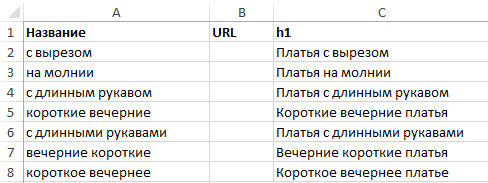
Таблица со значениями h1
В данном случае для генерации title используется значение из поля h1, поэтому он не представлен в таблице.
描述 — используем данные из столбика h1 和 делаем первую букву маленькой。 Для этого используем функцию «СТРОЧН» в Excel。
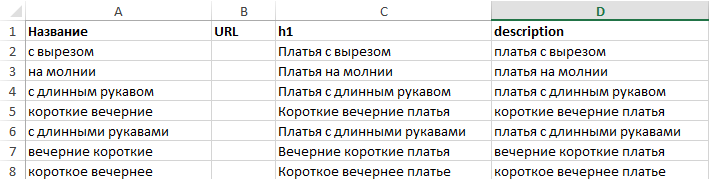
Таблица со значениями h1 和说明
描述。
Запросы из столбика 描述 добавляем в 钥匙收集器。 Отмечаем неявные дубли。
Вручную удаляем неявные дубли из нашей таблицы。 Обычно неявные дубли встречаются в небольших количествах, поэтому это несложно сделать。
故事内容:
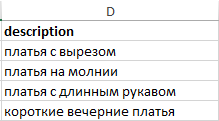
斯托尔比克描述
网址 — генерируем, используя функцию URL от Seo-Excel из поля 描述。
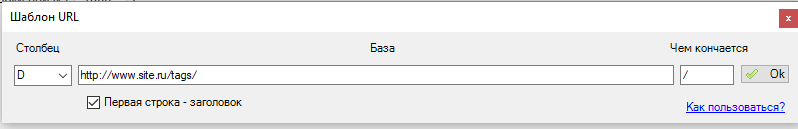
SEO-Excel 中的 URL 和 URL
我们得到:
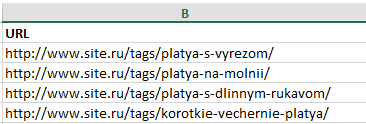
Сгенерированные URL
Ч и «Ч» — снимаем частотность любым удобным инструментом или сервисом。
Ч — используем для удаления запросов, не имеющих частотности. Для сезонных запросов можно дополнительно снимать частотность по месяцам。
«Ч» - используем для понимания, не является ли данный запрос составляющей другого запроса (возможно такого запроса не) существует)。
路径 — для данного проекта теги лежат внутри основного раздела.
Добавляем «Главная — Платья — » и потом то, что идет в h1.
В случае с вложенными тегами (когда один тег вложен в другой) путь может меняться。
Например, для запроса «Короткие вечерние платья» путь будет «Главная — Платья — Вечерние платья — Короткие вечерние платья»。
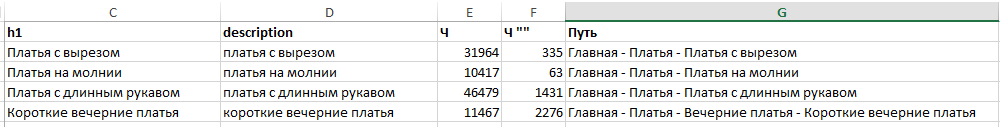
Таблица с заполненным столбиком «Путь»
Там же в зависимости от выбранного метода вывода ссылок может меняться название:
- если оно выводится на странице всех платьев, оно может иметь название «короткие вечерние»;
- если на странице вечерних платьев, то «короткие»。
Спримером、разобранным в задаче、можно ознакомиться в Google Docs。
优点:
- просто;
- не требуются дополнительные программы;
- хорошо подходит для сайтов с нестандартной URL-структурой。
缺点:
- больше ручной работы。
2. Парсинг программой 尖叫青蛙 SEO 蜘蛛
Для выполнения данного пункта потребуется программа Screaming Frog SEO Spider (платная)。
调整
Рассмотрим пример парсинга тегов со страницы Платья на сайте www.wildberry.ru。
Для начала в программе нам нужно заполнить две настройки.
配置 — 包括 (Правила включения)
Сюда мы добавим URL,с которых начинаются теги。 Эти теги будет добавлять програма。
网址:https://www.wildberry.ru/catalog/zhenshchinam/odezhda/platya/tags/
Добавляем таким образом:
| https://www.wildberries.ru/catalog/zhenshchinam/odezhda/platya/tags/.* |
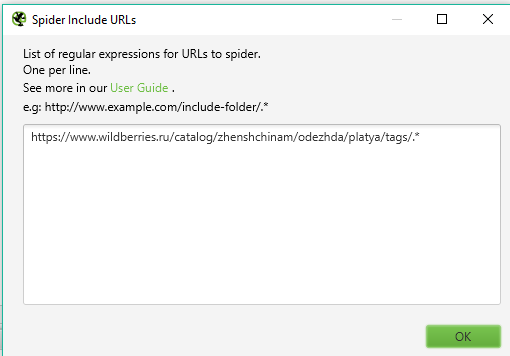
Screaming Frog SEO Spider 的 Окно для ввода параметров в «Правила включения» в
配置 — 排除 (Правила исключения)
Наша задача состоит в том, чтобы исключить страницы пагинациии, сортировки и страницы такого типа, которые по смыслу дублируют основную страницу。 Такие страницы не несут смысла для нашей задачи.
Исключаем по элементам, которые содержатся в URL: .*%элемент в URL%.*
У меня получилось так:
| 。*页-。* .*page=.* .*pagesize=.* |
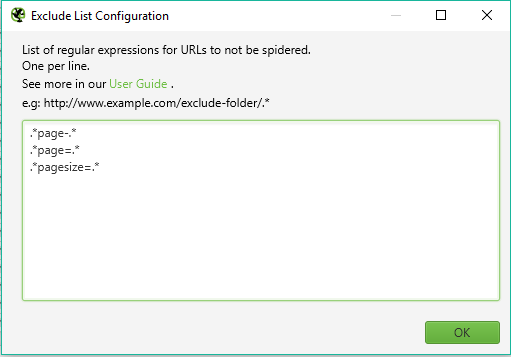
Screaming Frog SEO Spider 的 Окно для ввода параметров в «Правила исключения» в
Со временем соберется большой список таких параметров, и это упростит работу.
解析
Вбиваем URL основной страницы 和 нажимаем «开始»: https://www.wildberry.ru/catalog/zhenshchinam/odezhda/platya

尖叫青蛙 SEO 蜘蛛的 Окно ввода URL
313 号是 313 号。
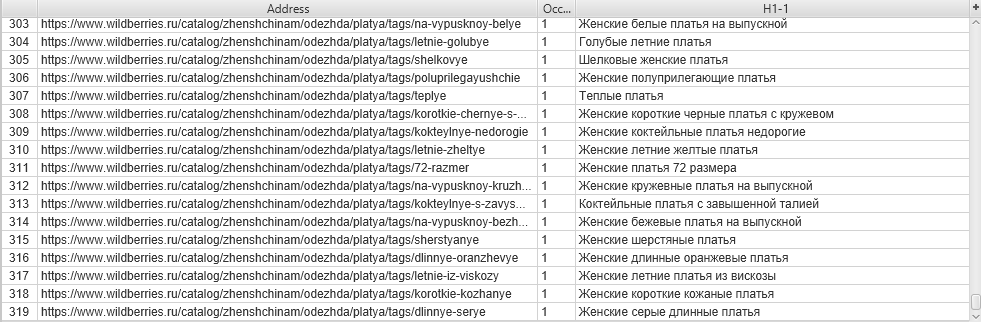
Значения вкладки «h1» в Screaming Frog SEO Spider
Дальше уже можем работать с тегами H1。
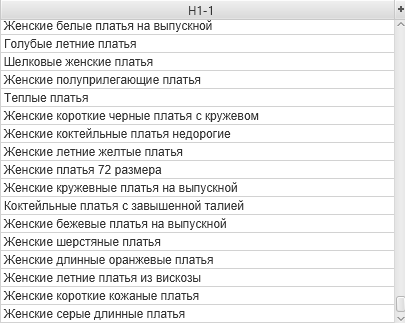
Значения столбика H1-1 вкладки «h1» в Screaming Frog SEO Spider
Google 文档中的 Спримером полученного результата можно ознакомиться。
Скорость ответа сервера у большинства сайтов с тегами быстрая。 Поэтому скорость парсинга будет зависеть от:
- настроек программы,
- мощности компьютера,
- 这是 DDoS 攻击的原因。
优点:
- програмный сбор информации。
缺点:
- 尖叫青蛙 SEO 蜘蛛;
- требуется настройка параметров исключения для страниц, дублирующих основную (пагинация, фильтры, сортировки);
- не у всех сайтов удобная URL-структура для парсинга тегов。
3. Парсинг из поисковой системы
Сбор страниц、начинающихся с определенного URL、из выдачи поисковой системы。
Для просмотра страниц нужно задать запрос вида:
| url:%URL с которого начинаются страницы тегов%* |
Например, чтобы посмотреть теги со страницы Платья на сайте www.wildberry.ru, нужно задать запрос вида:
| 网址:https://www.wildberry.ru/catalog/zhenshchinam/odezhda/platya/tags/* |
Ограничение Яндекса — не более 1000 результатов, поэтому если в выдаче более 1000 результатов, то парсим, каким-либо образом ограничивая количество результатов、например、побуквенно。
Если бы у нас было более 1000 результатов, мы собирали таким образом:
| 网址:https://www.wildberry.ru/catalog/zhenshchinam/odezhda/platya/tags/a* |
| 网址:https://www.wildberry.ru/catalog/zhenshchinam/odezhda/platya/tags/b* |
Парсить выдачу можно через 钥匙收集器。
Для совсем небольших сайтов при парсинге по буквам или по каким-то небольшим кластерам можно использовать выгрузку ТОП-100 сайтов по запросу в ПС Yandex от сайта Arsenkin.ru (быстро и бесплатно)。 Далее для этих страниц парсим h1 через SeoPult。
优点:
- програмный сбор информации
缺点:
- не все страницы, которые есть на сайте, могут быть проиндексированы;
- для некоторых сайтов требуется удалить страницы, дублирующие основную (пагинация, фильтры, сортировки);
- не у всех сайтов удобная URL-структура для парсинга тегов。
4. 在keys.so中输入URL
Сбор страниц с определенным URL в сервисе keywords.so。
1. Делаем отчет по сайту.
2. Смотрим отчет,где показываются все страницы сайта。
3. Фильтруем по полю «Адрес содержит», вбивая нужный элемент URL, чтобы показывались только теги.
示例:
| /catalog/zhenshchinam/odezhda/platya/tags |
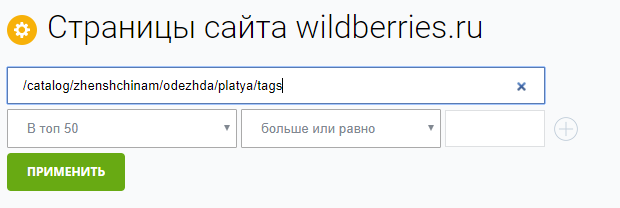
Поле для задания фильтров в сервисе keys.so
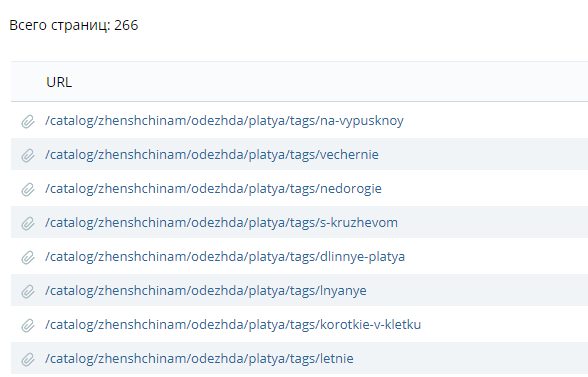
Список отфильтрованных страниц в сервисе keys.so
Далее для этих страниц парсим h1 через SeoPult。
优点:
- сбор информации через сервис;
- обычно отсутствуют страницы, дублирующие основную (пагинация, фильтры, сортировки)。
缺点:
- нужен доступ в Keys.so (платный);
- сервис показывает не все страницы, которые есть на сайте, а только те, где есть хотя бы 1 ключевое слово в ТОП 50;
- не у всех сайтов удобная URL-структура для парсинга тегов。
结论
Мы рассмотрели 4 способа быстрого сбора тегов для сайта. Эти способы позволяют сэкономить время на сборе 和 создании страниц тегов, сделав это быстрее, чем занимаясь ручной разгруппировкой семантического ядра。 У каждого метода свои плюсы и минусы。 Выбор способа зависит от задачи 和 имеющегося набора инструментов 和 сервисов。
___
编辑: Низамутинов Низамутинов
来源: seonews.ru